Baie informatique, switchs, onduleurs, brassage : ce qu’un local technique mal organisé finit toujours par coûter

Baie informatique, switchs, onduleurs, brassage : ce qu’un local technique mal organisé finit toujours par coûter

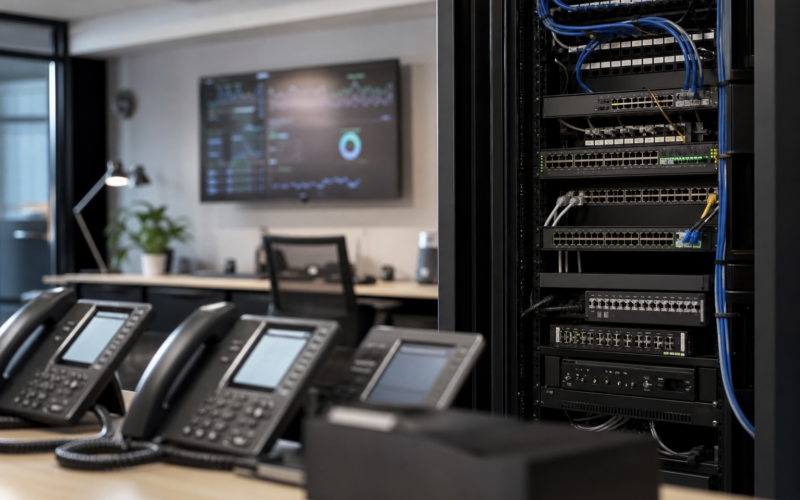
Dans beaucoup de PME, le local technique n’est jamais vraiment prioritaire tant que “tout marche”. On y trouve une baie à moitié pleine, des switchs ajoutés au fil des années, un onduleur installé sans réel suivi, quelques câbles qui pendent, et une logique connue seulement de la dernière personne qui est intervenue. Sur le moment, ce n’est pas forcément bloquant. Jusqu’au jour où un incident oblige à intervenir vite. ⚠️

C’est souvent là que le vrai coût apparaît : identifier le bon lien prend 20 minutes au lieu de 2, un redémarrage impacte le mauvais équipement, un switch n’est relié à rien de documenté, ou personne ne sait ce que protège réellement l’onduleur. La panne en elle-même n’est pas toujours grave. Ce qui coûte, c’est le temps perdu, l’incertitude et le risque d’erreur pendant l’intervention.

Dans un environnement multi-sites, industriel ou simplement exigeant, une baie mal organisée ne pénalise pas seulement l’IT. Elle ralentit la production, complique les dépannages à distance et rend chaque évolution plus chère que nécessaire. 🔧

Inventaire IT incomplet : pourquoi tant d’incidents partent d’équipements, de comptes ou de services que personne ne suit vraiment

Inventaire IT incomplet : pourquoi tant d’incidents partent d’équipements, de comptes ou de services que personne ne suit vraiment

Dans beaucoup de PME, les incidents ne viennent pas d’un “gros problème informatique”, mais d’un angle mort. Un poste jamais documenté, un compte admin encore actif après un départ, un switch installé dans un atelier sans être remonté dans aucun dossier, ou un abonnement cloud souscrit par une équipe puis oublié. Le jour où ça bloque, personne ne sait vraiment ce qui existe, à quoi cela sert, ni qui en dépend.

Sur le terrain, cela se traduit par des interventions plus longues, des diagnostics imprécis et des décisions prises à l’aveugle. On cherche une machine par son nom, puis par son IP, puis par son utilisateur. On découvre qu’un service critique reposait sur une box 4G, une SIM M2M ou un routeur industriel que personne n’avait intégré à la vision d’ensemble. Résultat : perte de temps, stress, et parfois arrêt partiel d’activité ⚠️

Un inventaire IT fiable n’est pas un document administratif de plus. C’est un socle opérationnel. Sans lui, le support, la sécurité, les renouvellements matériels et la continuité d’activité se dégradent progressivement, souvent sans que l’entreprise s’en rende compte.

Que faut-il vérifier avant de renouveler un firewall sans reproduire les fragilités de l’existant ?

Que faut-il vérifier avant de renouveler un firewall sans reproduire les fragilités de l’existant ?

Dans beaucoup de PME, le renouvellement d’un firewall arrive dans l’urgence : matériel en fin de vie, changement d’opérateur, ajout d’un nouveau site ou incident de sécurité qui pousse à agir vite. Le réflexe est alors de remplacer l’équipement à l’identique, de migrer la configuration et de remettre le réseau en route au plus vite. Sur le papier, cela semble simple. Sur le terrain, c’est souvent là que les problèmes recommencent ⚠️

On retrouve des règles accumulées depuis des années, des accès ouverts pour d’anciens prestataires, des VPN dont plus personne ne sait vraiment à quoi ils servent, ou des flux métiers critiques mélangés à des usages bureautiques classiques. Résultat : le nouveau firewall hérite des mêmes lenteurs, des mêmes angles morts et parfois des mêmes risques de sécurité que l’ancien.

Un renouvellement de firewall doit donc être traité comme un sujet d’architecture et de continuité de service, pas comme un simple achat matériel. Avant de choisir un modèle ou de planifier une migration, il y a plusieurs vérifications indispensables à faire pour éviter de déplacer les fragilités au lieu de les corriger.

Messagerie, fichiers, applications, VPN : comment cartographier les dépendances critiques avant qu’une panne ne bloque toute l’activité

Messagerie, fichiers, applications, VPN : comment cartographier les dépendances critiques avant qu’une panne ne bloque toute l’activité

Dans beaucoup de PME, on sait lister les outils du quotidien : la messagerie, le serveur de fichiers, l’ERP, le VPN, la téléphonie, quelques applications métiers et parfois une connexion dédiée pour un atelier ou un site distant. En revanche, on connaît rarement les dépendances réelles entre ces briques. Le jour où un incident survient, on découvre que la panne visible n’est que la première pièce qui tombe. ⚠️

Un exemple classique : la messagerie fonctionne mal sur un site, mais le vrai problème vient d’un accès Internet dégradé, d’un routeur saturé, d’un DNS mal relayé ou d’un tunnel VPN qui transporte aussi d’autres flux essentiels. Résultat, les équipes ne peuvent plus envoyer de devis, accéder aux fichiers partagés, valider des commandes ou joindre un support externe. La panne ne touche pas « un outil », elle bloque une chaîne de travail complète.

C’est précisément l’intérêt d’une cartographie des dépendances critiques : comprendre à l’avance ce qui tient réellement votre activité, où se situent les points de rupture invisibles, et quels incidents doivent être traités en priorité pour éviter l’arrêt de production, la désorganisation administrative ou l’immobilisation d’un site. 🔎

Postes partagés, ateliers, accueil, production : comment sécuriser les usages sur un même ordinateur sans compliquer le quotidien

Postes partagés, ateliers, accueil, production : comment sécuriser les usages sur un même ordinateur sans compliquer le quotidien

Dans beaucoup de PME, les postes partagés se sont installés presque naturellement : un PC à l’accueil, un écran en atelier, un terminal en logistique, un poste de supervision en production, un ordinateur dans une salle de réunion. Sur le terrain, cela rend service. Mais avec le temps, les mêmes problèmes reviennent : sessions ouvertes toute la journée, mots de passe connus de tout le monde, fichiers enregistrés sur le bureau, accès trop larges, et plus personne ne sait vraiment qui a fait quoi.

Le sujet paraît secondaire jusqu’au jour où un logiciel métier ne fonctionne plus, qu’un document sensible est modifié par erreur, qu’une impression part au mauvais endroit, ou qu’un poste bloqué ralentit une équipe entière. Dans un atelier ou sur un site industriel, ce n’est pas seulement un sujet informatique : cela peut vite perturber la production, le planning ou la traçabilité. ⚙️

La bonne approche n’est pas de compliquer l’usage avec des procédures impossibles à tenir. Il s’agit plutôt d’adapter le poste à son contexte réel d’utilisation, pour garder un fonctionnement simple, robuste et supportable dans la durée.

Gestion des droits admin locaux : ce qu’il faut revoir avant qu’un simple poste devienne un point d’entrée sur tout le SI

Gestion des droits admin locaux : ce qu’il faut revoir avant qu’un simple poste devienne un point d’entrée sur tout le SI

Dans beaucoup de PME, le sujet des droits administrateur local reste traité “plus tard”. Un logiciel métier à installer vite, un utilisateur autonome, un prestataire qui intervient ponctuellement : au fil du temps, on laisse des comptes avec trop de privilèges sur les postes, parce que cela dépanne sur le moment. Jusqu’au jour où un poste devient le maillon faible de tout le système d’information.

Sur le terrain, les effets sont très concrets : installation d’outils non validés, agents de sécurité désactivés, pilotes bricolés, scripts lancés sans contrôle, et parfois une infection qui ne reste pas cantonnée à une seule machine. Ce n’est pas seulement un sujet de cybersécurité 🔒. C’est aussi un sujet de support, de standardisation et de continuité d’activité.

La difficulté, c’est qu’on ne peut pas supprimer brutalement tous les droits élevés sans tenir compte des usages réels. L’enjeu consiste plutôt à reprendre le contrôle intelligemment : identifier les vraies exceptions, encadrer les élévations ponctuelles et remettre de la cohérence dans la gestion du poste de travail.

Combien de temps pouvez-vous travailler sans informatique ? La méthode simple pour évaluer votre vraie tolérance à l’arrêt

Combien de temps pouvez-vous travailler sans informatique ? La méthode simple pour évaluer votre vraie tolérance à l’arrêt

Dans beaucoup de PME, la question ne se pose jamais clairement. On sait qu’une panne serait gênante, parfois très gênante, mais personne n’a vraiment chiffré combien de temps l’entreprise peut continuer à fonctionner si l’ERP n’est plus accessible, si les postes deviennent inutilisables ou si un site distant perd sa connexion. Le plus souvent, on découvre la réponse le jour où tout s’arrête. ⚠️

Sur le terrain, les blocages ne viennent pas uniquement d’une grosse panne serveur. Une simple coupure Internet sur un site isolé, un VPN instable, une sauvegarde incomplète, un pare-feu saturé ou un applicatif métier qui ralentit peuvent suffire à désorganiser la production, retarder les expéditions, empêcher la saisie administrative ou bloquer la facturation. Et là, les heures perdues deviennent vite des coûts cachés.

La bonne approche n’est pas de partir de la technique, mais de l’activité réelle. Avant de parler PRA, supervision, redondance ou infogérance, il faut répondre à une question simple : combien de temps pouvez-vous réellement travailler sans informatique, sans impact majeur sur votre entreprise ?

Onboarding et départ de collaborateurs : comment éviter que la gestion des comptes et des accès devienne un risque pour l’entreprise

Onboarding et départ de collaborateurs : comment éviter que la gestion des comptes et des accès devienne un risque pour l’entreprise

Dans beaucoup de PME, l’arrivée ou le départ d’un collaborateur se gère encore “au fil de l’eau”. Un mail des RH, un appel au support, un PC préparé dans l’urgence, un badge désactivé mais une boîte mail encore active, ou l’inverse. Sur le moment, cela paraît anodin. En pratique, c’est souvent là que commencent les oublis, les allers-retours inutiles et les petits incidents qui finissent par désorganiser la journée. 🔧

Le problème ne touche pas seulement la sécurité. Il impacte aussi la continuité opérationnelle : un nouvel arrivant sans accès à Microsoft 365 le premier matin, un technicien terrain qui ne peut pas ouvrir son VPN sur un site isolé, un collaborateur parti depuis trois semaines dont le compte reste actif sur une application métier, ou un changement de poste interne qui conserve des droits devenus incohérents. Dans les environnements industriels ou multisites, ces écarts coûtent encore plus cher, parce qu’ils bloquent des opérations très concrètes. ⚠️

Téléphonie d’entreprise : comment préparer la fin d’un standard vieillissant sans perturber l’activité

Téléphonie d’entreprise : comment préparer la fin d’un standard vieillissant sans perturber l’activité

Dans beaucoup de PME, la téléphonie tient encore parce qu’“elle fonctionne à peu près”. Jusqu’au jour où un poste ne sonne plus, où une file d’appels se bloque, ou qu’un redémarrage du standard devient une opération délicate parce que plus personne ne maîtrise vraiment l’installation. Ce type de situation arrive souvent sur des systèmes en place depuis 10, 15 ou 20 ans, avec quelques rustines ajoutées au fil du temps 📞.

Le problème, c’est que la téléphonie reste un outil critique. Quand les appels entrants sont mal distribués, quand un site distant décroche avec retard, ou quand l’accueil n’a plus de visibilité sur les transferts, l’impact est immédiat : perte de temps, image dégradée, demandes clients mal traitées, et parfois rupture dans la chaîne opérationnelle.

Préparer la fin d’un standard vieillissant ne consiste donc pas seulement à changer d’opérateur. C’est un sujet d’infrastructure, de réseau et de continuité de service. Si la migration est bien préparée, la bascule peut être propre. Si elle est traitée trop vite, elle crée souvent plus de problèmes qu’elle n’en résout.

Documentation IT : ce que beaucoup d’entreprises découvrent trop tard lors d’un départ de prestataire ou d’un incident majeur

Documentation IT : ce que beaucoup d’entreprises découvrent trop tard lors d’un départ de prestataire ou d’un incident majeur

Le problème apparaît rarement un mardi matin calme. En général, il se révèle au pire moment : un serveur qui ne redémarre pas, un VPN intersite qui tombe, un prestataire qui n’intervient plus, ou une migration urgente à lancer sans visibilité claire sur l’existant. À ce moment-là, beaucoup d’entreprises découvrent que leur documentation informatique n’est pas vraiment une documentation : quelques mots de passe envoyés par mail, un schéma réseau vieux de trois ans, un classeur incomplet, et beaucoup d’informations “connues” seulement par une personne. ⚠️

Dans une PME, cette faiblesse se paie vite. Les équipes cherchent, appellent, testent, supposent. Le temps perdu ne se voit pas toujours dans un tableau de bord, mais il se traduit en production bloquée, utilisateurs à l’arrêt, prestataires qui avancent à l’aveugle et arbitrages pris dans l’urgence. Sur des sites techniques ou industriels, avec des routeurs 4G/5G, des SIM M2M, des VPN ou des équipements isolés, le manque de documentation peut même empêcher une reprise d’exploitation rapide. 🔧