Postes de travail hétérogènes, exceptions locales, modèles hors standard : jusqu’où un parc peut-il rester supportable ?
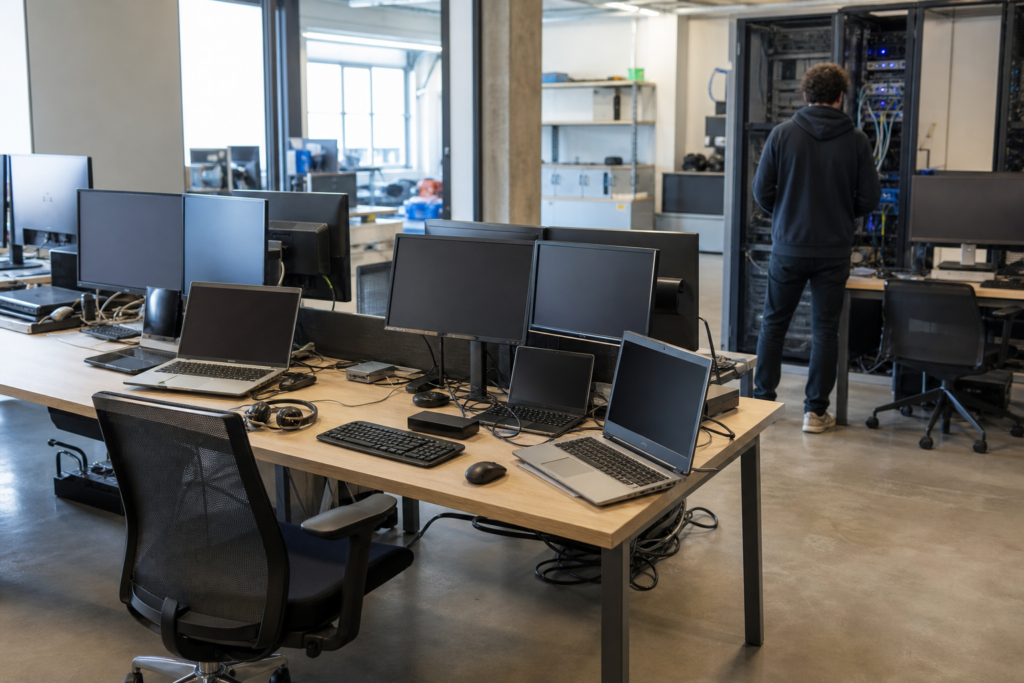
Au début, l’hétérogénéité d’un parc passe souvent pour un détail. Un PC acheté en urgence pour remplacer une machine en panne, un portable plus puissant pour un bureau d’études, un logiciel installé uniquement sur un site parce que “chez eux, ils en ont besoin”. Sur le moment, chaque exception paraît logique. Mais quelques années plus tard, le support se retrouve avec dix modèles différents, des versions de Windows pas toujours alignées, des pilotes introuvables et des habitudes locales qui ne sont documentées nulle part.
Le problème, ce n’est pas seulement que le parc est hétérogène. C’est qu’il devient difficile à maintenir sans perte de temps, sans contournement et sans risque. Une intervention simple prend deux fois plus longtemps, un renouvellement oblige à refaire des réglages manuels machine par machine, et certaines pannes ne se résolvent plus proprement 😐. Le parc reste “fonctionnel”, mais il n’est plus vraiment supportable au quotidien.
Un parc informatique peut fonctionner longtemps avant de devenir ingérable
Dans beaucoup de PME, la dérive se fait progressivement. Elle accompagne la croissance, l’ouverture de nouveaux sites, l’arrivée de nouveaux métiers ou tout simplement l’absence de temps pour remettre les standards à plat. Le parc n’est pas en panne généralisée, donc le sujet reste secondaire. Pourtant, côté support, les signaux faibles s’accumulent.
On le voit très bien sur des environnements multi-sites ou techniques : un atelier conserve un vieux poste pour faire tourner un logiciel de programmation machine, un site isolé garde un routeur configuré “à part”, une équipe terrain utilise un portable spécifique parce qu’il supporte encore un périphérique ancien. Individuellement, ces écarts peuvent se justifier. Collectivement, ils créent une dette d’exploitation.
Le seuil critique n’est pas lié à un nombre précis de modèles ou d’exceptions. Il est atteint quand le support dépend de connaissances implicites, d’habitudes locales ou de manipulations non industrialisées. À partir de là, chaque incident coûte plus cher qu’il ne devrait, même quand il paraît mineur.
Un parc reste acceptable tant que ses écarts sont connus, documentés et supportables. Quand les exceptions deviennent invisibles ou informelles, le coût réel explose.
Les signaux concrets d’un parc encore utilisable, mais de moins en moins maintenable
Le premier signe, c’est l’allongement des temps de support. Un incident banal — imprimante qui disparaît, poste trop lent, profil utilisateur corrompu, VPN instable — ne se règle plus avec une procédure standard. Il faut vérifier le modèle, la version du système, les logiciels installés localement, la présence d’un ancien agent ou d’un paramètre spécifique au site. Ce temps perdu ne se voit pas toujours dans les tableaux de bord, mais il pèse sur tout le reste ⏱️.
Deuxième signal : les renouvellements deviennent pénibles. Sur le papier, remplacer un poste devrait être une opération cadrée. En réalité, on découvre au dernier moment qu’une application métier n’a jamais été packagée, qu’un scanner de production a besoin d’un vieux pilote, ou qu’un utilisateur travaille avec des droits locaux depuis des années “parce qu’autrefois, ça ne marchait pas autrement”. La migration prend alors des heures, parfois des jours. Dans ce type de contexte, un audit IT du parc informatique permet souvent d’objectiver les écarts et de prioriser les actions.
Troisième signal : la qualité de service devient inégale selon les sites ou les profils. Un même problème n’a pas la même cause partout, donc pas la même rapidité de résolution. Cela crée de l’incompréhension côté utilisateurs, et une forme d’usure côté IT. On passe d’un support organisé à un support d’exception permanente.
- incidents récurrents sur certains modèles uniquement ;
- postes impossibles à reconfigurer rapidement en cas de panne ;
- logiciels installés hors procédure ou sans référentiel clair ;
- écarts de configuration entre sites qui compliquent le dépannage à distance.
Ce que l’hétérogénéité du parc coûte vraiment au-delà du matériel
On réduit souvent le sujet à une question de confort d’administration. En pratique, les impacts sont beaucoup plus concrets. Le premier coût caché, c’est le temps. Un technicien qui consacre 45 minutes à comprendre un poste atypique ne les passe pas sur d’autres demandes, sur de la prévention ou sur des actions d’amélioration. Multipliez cela par des dizaines d’incidents par mois, et la facture opérationnelle grimpe vite.
Il y a ensuite le risque de rupture. Lorsqu’un poste spécifique tombe en panne et qu’aucun modèle de remplacement compatible n’est prêt, l’activité métier se bloque. Dans un environnement industriel ou sur un site distant, ce n’est pas un simple désagrément : cela peut retarder une intervention, empêcher l’accès à une supervision, ou ralentir une production. Le problème n’est plus informatique, il devient opérationnel ⚠️.
Enfin, plus le parc s’écarte du standard, plus l’infogérance et le support informatique perdent en efficacité. Un modèle forfaitaire fonctionne bien quand le périmètre est stable, documenté et reproductible. À l’inverse, un parc rempli d’exceptions locales oblige à faire du cas par cas, donc à consommer du temps de support sur des sujets qui devraient être simples. Le parc reste pris en charge, mais dans de moins bonnes conditions de fiabilité et de réactivité.
Sur le plan éditeur, Microsoft rappelle par ailleurs l’importance de maintenir des environnements à jour et standardisés pour améliorer la qualité du support et la sécurité des postes : documentation officielle sur le déploiement Windows.
Pourquoi tout standardiser d’un coup est rarement la bonne réponse
Quand on prend conscience du problème, la tentation est de vouloir “nettoyer” rapidement. Dans les faits, une remise au standard brutale fonctionne mal. Certaines exceptions ont une vraie raison métier : compatibilité d’un automate, interface avec un équipement ancien, logiciel vertical mal supporté, contraintes réseau d’un site isolé. Les supprimer sans analyse peut casser les usages plus sûrement que l’hétérogénéité elle-même.
Le bon réflexe consiste plutôt à distinguer les écarts utiles des écarts subis. Un poste spécifique peut être acceptable s’il est identifié, documenté, maîtrisé et intégré dans un cadre de support clair. En revanche, un écart hérité dont personne ne connaît l’origine, ou qui repose sur une vieille habitude locale, doit être questionné. C’est là que beaucoup de parcs dérivent : non pas à cause de besoins réels, mais faute d’arbitrage dans le temps.
Autrement dit, l’objectif n’est pas un parc théoriquement parfait. L’objectif est un parc dont les exceptions restent supportables 🙂. Cela change la manière de prioriser les actions.
Standardiser ne veut pas dire uniformiser aveuglément. Cela consiste surtout à réduire la complexité là où elle n’apporte aucune valeur métier.
Une méthode réaliste pour remettre le parc à plat sans bloquer les métiers
La première étape consiste à cartographier ce qui existe réellement, pas ce qui est censé exister. Modèles de postes, versions système, logiciels installés, profils à privilèges élevés, dépendances locales, périphériques sensibles, écarts entre sites : il faut une vision terrain. Dans les PME en croissance, cette photographie réserve presque toujours quelques surprises.
Ensuite, il faut classer les écarts en trois catégories : ceux qu’on supprime, ceux qu’on intègre dans un standard mis à jour, et ceux qu’on conserve comme exceptions encadrées. Cette phase est essentielle, car elle évite de traiter de la même manière un ancien bricolage et une vraie contrainte métier 🔎.
- définir 2 ou 3 modèles de postes maximum par type d’usage ;
- formaliser une base logicielle commune par population ;
- documenter les exceptions autorisées avec leur justification et leur mode de support ;
- profiter des renouvellements et des incidents majeurs pour remettre au standard progressivement.
Cette approche progressive est souvent la plus efficace. Elle évite un projet lourd tout en réduisant rapidement les points de friction. Un poste remplacé, un site migré, un logiciel reconditionné : chaque action retire de la complexité au lieu d’en ajouter. Au bout de quelques mois, les délais de support se raccourcissent et les renouvellements redeviennent prévisibles. Lorsqu’un changement plus large est nécessaire, une démarche structurée de migration ou transformation IT aide à remettre le parc au standard sans perturber les utilisateurs.
Pour cadrer les bonnes pratiques de gestion et de cycle de vie des actifs, les recommandations de l’ITIL restent également une référence utile, notamment sur la standardisation et la maîtrise des configurations.
Le vrai bon niveau n’est pas l’uniformité, mais la supportabilité du parc
Un parc de PME n’a pas besoin d’être parfaitement homogène pour être bien géré. En revanche, il doit rester compréhensible, documenté et administrable sans dépendre de personnes clés ou de manipulations artisanales. C’est ce point d’équilibre qui permet d’assurer un support fiable, y compris quand l’entreprise s’étend sur plusieurs sites ou s’appuie sur des environnements techniques plus exigeants.
Quand les exceptions deviennent la norme, le parc cesse d’être un outil maîtrisé. Il fonctionne encore, parfois longtemps, mais il devient lent à dépanner, compliqué à faire évoluer et plus risqué à maintenir. Revenir à un niveau de supportabilité acceptable ne suppose pas de tout refaire. Cela demande surtout de reprendre la main sur les écarts, de décider lesquels ont un sens, et de remettre de la cohérence là où elle s’est perdue 🛠️. Dans les organisations multi-sites, cette remise à plat gagne aussi à être pilotée avec une vision transversale, par exemple via une DSI externalisée capable d’arbitrer entre contraintes locales et standard global.
Si vous constatez des temps de support qui s’allongent, des exceptions locales qui s’accumulent ou des renouvellements devenus imprévisibles, c’est souvent le bon moment pour réévaluer la supportabilité réelle de votre parc avant qu’un incident critique ne révèle toute la dette accumulée.